Сообщения

Показаны сообщения с ярлыком "BigData"

Kafka больше чем жизнь.

Изображение
Kafka 2.0 Зарелизилась вторая Kafka. С нумерацией там чудеса, в том плане, что настоящих прям breaking changes а-ля KSQL/KStreams мы там не увидим, хотя и фич-лист впечатляет.  RELEASE_NOTES   Понятно, что все больше и больше внимания уделяется Kafka Connect, более стабильным (судя по количеству пофиксенных багов) является взгляд на поток ивентов как на "потенциально бесконечную таблицу".  Но блин, мы все это видели и в 1.1, да? Стоило ли добавлять двоечку? Или это все было затеяно, чтобы разорвать связи с прекрасной и легальной на все времена Java 7? Confluent в сговоре с Oracle двигает нас в светлое будущее? Да, люди, которые гоняют секретную Kafk-у в подвалах ЦРУ обрадуются фичам, относящимся к запароливанию доступа, но так-то, в Бигдатушке, по-другому безопасностию занимаются средние девелоперы. Резюмирую: те же мессаги, только в профиль. Получите more security, stability and reliability и распишитесь. Scala Wrapper Пока всех тошнит от нового релиза Kafka...
10 причин раздражаться при использовании Apache Spark

Изображение
Все больше и больше проектов уходит от поддержки парадигмы MapReduce на базе Hadoop и двигается в сторону нового кумира - Spark. Разработчики Mahout перестали воплощать новые алгоритмы машинного обучения на MR, обещая переехать в будущем на Spark Pipeline API. Наши любимые дистрибутивы от Cloudera и Hortonworks все больше и больше насыщаются инструментарием Spark. Однако, из разных уголков мира Big Data слышны голоса скептиков, уже сделавших несколько проектов на Spark, тех первопроходцев, которые уже успели хлебнуть лиха на боевых проектах и теперь видят разницу между рекламными проспектами и суровой реальностью. Итак, представляю вам попытку обобщить свой опыт и опыт коллег в разработке Java - приложений, работающих со Spark. Java API в долямбдовую эпоху Если вы Java - разработчик, то вы с большой вероятностью начинали свои эксперименты со Spark, развернув виртуальную машину из какого-либо образа, вроде текущего HDP 2.3, на котором стоит Java 7 по умолч...

Big Data on your local machine : Installing Hadoop Cluster (Multi Node regime)

Изображение
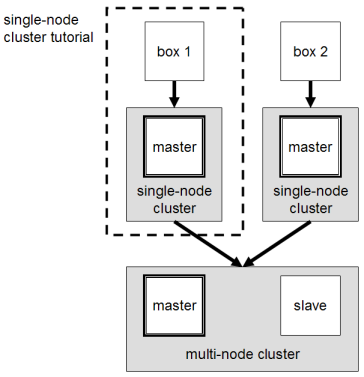
A few days ago I published an article about Hadoop installation (in Single Node regime). After that  I received so many emails  from guys who wanted to change their single node to cluster (Multi-Node regime). So, I’ll help you ‘cause I had similar problems a few months ago when my System Administrator took his holidays and left me face to face with a lot of single machines without Cluster Ring of Power. Thinking about future cluster Let’s start! Of course, we should have a Virtual Machine (VM) with Ubuntu 14.10 and installed Hadoop 2.6.0 according instructions from previous paper . In the first, we need to design future cluster and understand how many nodes are required for our deals. If it is your first cluster and your have few separated primary nodes, it will be easy to join them one by one. The master node will run the ‘father’ threads for each floor: NameNode for the HDFS storage layer, and JobTracker for the MapReduce proce...

Highload ++ 2014 глазами докладчика

Изображение
К конференции Highload у меня весьма трепетное отношение, ибо моя первая поездка на нее в 2012 стабилизировала хаотичные на тот момент знания в некую упорядоченную цепь, структуру и предоставила наиболее широкий обзор текущего рынка Highload технологий в России и за ее пределами. В 2013 году я с удовольствием смотрел онлайн-трансляцию вечером из офиса Тамтэка, обсуждая с коллегами преимущества Rabbit MQ, дубльгисовские попытки запихать все в Neo4j, а также доклад нашего коллеги Дениса Нелюбина о сравнении производительности NoSQL баз данных (Aerospike, Couchbase, Mongo, Cassandra) на нашем тестовом фреймворке, в разработке которого я сам принимал участие годом ранее. В 2014, 14 марта, в свой день рождения, я отправил заявку с описанием доклада на Highload и стал ждать. После полугода  мне пришло подтверждение и я отправился в путь, надеясь не только познакомиться с коллегами, работающими в смежных областях, но и поднять свое Big Data сознание на новой уровень. И нас...