Сообщения

Показаны сообщения с ярлыком "Hadoop"

10 причин раздражаться при использовании Apache Spark
Изображение
Все больше и больше проектов уходит от поддержки парадигмы MapReduce на базе Hadoop и двигается в сторону нового кумира - Spark. Разработчики Mahout перестали воплощать новые алгоритмы машинного обучения на MR, обещая переехать в будущем на Spark Pipeline API. Наши любимые дистрибутивы от Cloudera и Hortonworks все больше и больше насыщаются инструментарием Spark. Однако, из разных уголков мира Big Data слышны голоса скептиков, уже сделавших несколько проектов на Spark, тех первопроходцев, которые уже успели хлебнуть лиха на боевых проектах и теперь видят разницу между рекламными проспектами и суровой реальностью. Итак, представляю вам попытку обобщить свой опыт и опыт коллег в разработке Java - приложений, работающих со Spark. Java API в долямбдовую эпоху Если вы Java - разработчик, то вы с большой вероятностью начинали свои эксперименты со Spark, развернув виртуальную машину из какого-либо образа, вроде текущего HDP 2.3, на котором стоит Java 7 по умолч...
Big Data on your local machine : Installing Hadoop Cluster (Multi Node regime)

Изображение
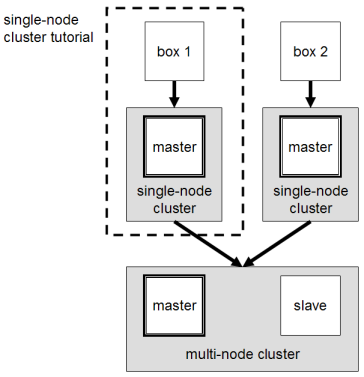
A few days ago I published an article about Hadoop installation (in Single Node regime). After that  I received so many emails  from guys who wanted to change their single node to cluster (Multi-Node regime). So, I’ll help you ‘cause I had similar problems a few months ago when my System Administrator took his holidays and left me face to face with a lot of single machines without Cluster Ring of Power. Thinking about future cluster Let’s start! Of course, we should have a Virtual Machine (VM) with Ubuntu 14.10 and installed Hadoop 2.6.0 according instructions from previous paper . In the first, we need to design future cluster and understand how many nodes are required for our deals. If it is your first cluster and your have few separated primary nodes, it will be easy to join them one by one. The master node will run the ‘father’ threads for each floor: NameNode for the HDFS storage layer, and JobTracker for the MapReduce proce...